AIサポートシステムの提供開始について
 sdccadmin
島根データセンター友の会では、この度、「つながらない」「申請が進まない」という問い合わせに、AI がその場で一次対応するサポートシステムを開発、提供開始しました。
マニュアルを返すだけのチャットボットではなく、MARS(当団体が開発した SDN プロビジョニング基盤の総称、以下 MARS)の台帳(申請によって払い出された回線・経路・サーバーなどの構成の記録)と、実際の装置の応答を確かめたうえで回答します。
本記事では、本システムの概要について解説します。
開発の背景とねらい
これまでのサポートでは、問い合わせを受けてから担当者が対応を始めるまでに、平均で 2〜3 営業日かかっていました。問い合わせのおよそ 6 割は申請の不足や設定の誤りなど利用者側に原因があるもので、その確認に対応人員の時間の多くが割かれていました。
その結果、当団体側の対応が本当に必要な問い合わせほど着手が遅れるという状況が生まれていました。
本システムは、この初動対応を自動化します。
利用者が質問した時点で申請の状態と装置の状態を調べ、原因の候補を返すため、担当者を待たずに切り分けが始まります。利用者側の原因で解決できる問い合わせは AI の段階で片付き、担当者のもとには当団体の確認が必要なものだけが、調べた結果を添えて届きます。これにより、対応開始までの時間の短縮と、対応人員の負荷の削減を見込んでいます。
利用者は MARS と同じアカウントでログインし、自分の契約について質問します。システムは申請の状態を調べて失敗・保留や申請の不足を指摘するほか、MARS の台帳と Looking Glass(当団体のルーターの接続状態や経路を Web から読み取り専用で確認できるツール、以下 LG)で見たルーター・スイッチの状態を突き合わせて故障の原因の候補を示し、マニュアルを引いて操作のしかたや必要な申請の順番を案内します。
当団体側の確認が必要な場合は、当団体の問い合わせ窓口(チャットサービスの Discord 上に設けています)にそのまま貼り付けられる「引き継ぎ票」(調べた内容と問い合わせ番号をまとめた定型の文面)を出します。
判断はコード、LLM は説明役
LLM(大規模言語モデル)には、オンプレミスの GPU(NVIDIA Tesla T4、メモリ 16GB)で動く qwen3:14bを使っています。外部のクラウドサービスにお客様の構成情報を渡さずに済む一方、この規模のモデルに判断まで任せると誤りが多くなります。そこで本システムでは、MARS の設計方針である「判断はコードで行う」をそのまま持ち込みました。申請の判定、調べる装置やコマンドの選択、原因の絞り込み、利用者に聞き返す項目の決定はすべてコードが行い、LLM が担当するのは利用者の文章の解釈と、結果をわかりやすく説明することだけです。
開発の過程でパラメータ数 8B・14B・32Bのモデルを比較しましたが、32B に上げても精度はほとんど変わりませんでした。一方で、コードが先に確定させる範囲を広げるたびに、回答の質ははっきりと改善しました。モデルの大きさより、何をコードで決めておくかのほうが効くというのが、開発を通じて得た実感です。
flowchart LR
  subgraph User["利用者"]
    B["ブラウザ<br/>チャット画面"]
  end

  subgraph Support["問い合わせ Web(docker)"]
    APP["対話サーバー"]
    HEAR["聞き取り"]
    LOOP["LLM とツールの往復"]
    subgraph Tools["ツール"]
      TM["MARS の読み取り・申請の点検"]
      TL["LG・切り分け"]
      TS["マニュアル検索"]
      TP["申請の前提関係表"]
    end
    DB[("PostgreSQL<br/>会話・ツール実行記録")]
  end

  subgraph LLM["LLM サーバー(T4×4)"]
    O1["Ollama<br/>GPU ごとに 1 つ"]
  end

  subgraph Ops["既存の運用基盤"]
    MARS["MARS の API"]
    LGO["LG(作業者向け)"]
    DOC["ユーザーマニュアル・手引"]
  end

  NW["ルーター・スイッチ"]

  B -- "途中経過を逐次表示" --> APP
  APP --> HEAR
  APP --> LOOP
  APP --> DB
  HEAR -- "対象の特定" --> TM
  LOOP <--> O1
  LOOP --> TM & TL & TS & TP
  TM -- "読み取り" --> MARS
  TL -- "JSON API" --> LGO
  LGO -- "show" --> NW
  DOC -- "取り込み" --> TS
全体の構成は上の図のとおりです。対話サーバーは Node.js 24・Express・PostgreSQL 16 で作り、LLM は別のサーバーで Ollama上に動かし、OpenAI 互換の API で接続しています。
問い合わせ 1 件の流れ
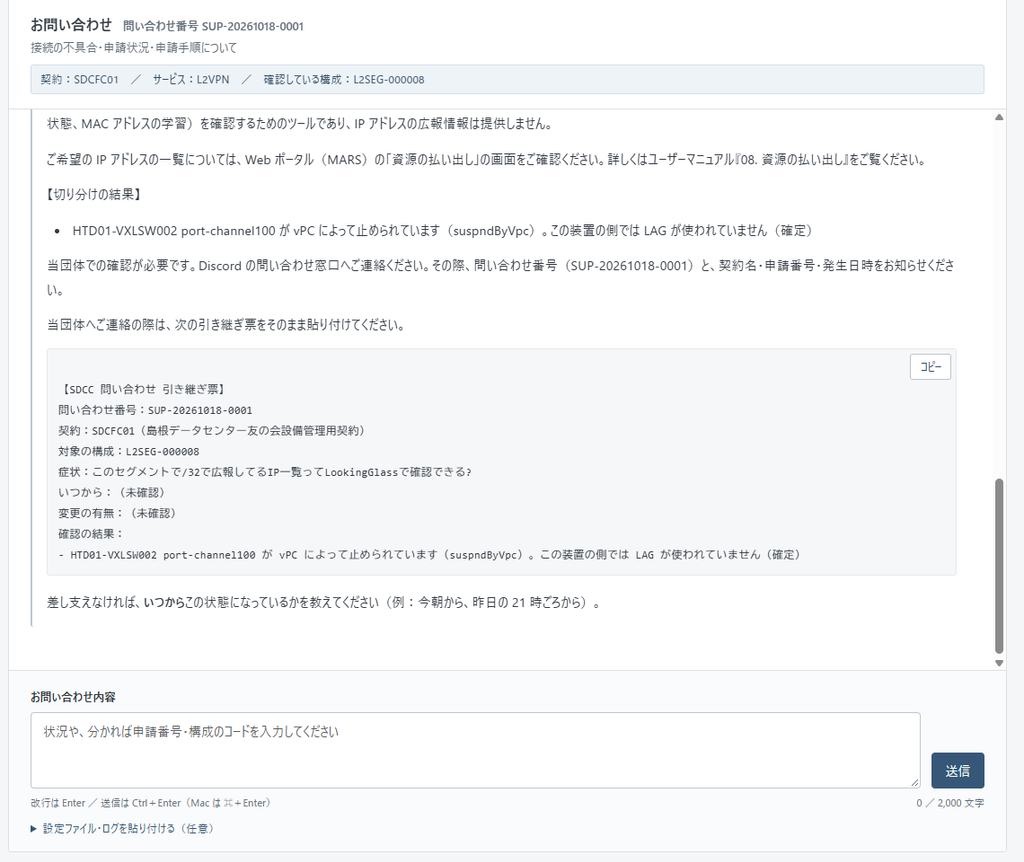
利用者から問い合わせが届くと、LLM を呼ぶ前に、コードが調べる対象を決めて確認を済ませておきます。小さいモデルは、ツールを呼ばずに推測で答えてしまうことが多かったためです。
sequenceDiagram
  autonumber
  actor U as 利用者
  participant A as 対話サーバー
  participant M as MARS
  participant L as 作業者向け LG
  participant G as LLM

  U->>A: 「VRF30 の拠点から外に出られません」
  A->>A: 問い合わせ番号を採番
  A->>M: VRF30 → VRF-000030 を台帳で特定
  alt 候補が複数ある・情報が足りない
    A-->>U: 選択肢を出して聞き返す(LLM は使わない)
  else 対象が決まった
    A-->>U: 途中経過「VRF-000030 を確認します」
    A->>M: VRF・SVI・相互接続の台帳
    A->>L: SVI・リンク・ping・BGP・default 経路
    A->>A: 事実と原因の候補を判定
    A-->>U: 途中経過「ER との BGP:確立/default:なし」
    A->>A: マニュアル・手引の該当章を検索
    A->>G: 判定結果と引用候補を渡して説明文を依頼
    G-->>A: 説明文
    A->>A: 引用の検査・連絡先の追記・引き継ぎ票の作成
    A-->>U: 回答・画面例・引き継ぎ票
  end
図の例にある VRF は、ルーターの中で経路表を契約ごとに分ける仕組みで、L3VPN(拠点間をルーティングでつなぐサービス)の単位になっています。SVI は VLAN に割り当てたルーティング用のインターフェース、ER は当団体のエッジルーター(インターネットとの境界にあるルーター)です。
最初に行うのは聞き取りです。どの構成について、何が起きているのかを、コードが判断して足りない分だけを聞き返します。対象の構成は、正式なコードはもちろん、「VRF30」のような略記や表示名、アドレス、AS 番号からでも台帳を引いて特定します。候補が複数あれば選択肢のボタンを出して選んでもらい、発生時期や直前の変更の有無もこの段階で確認します。聞き返しには LLM を使わないので、応答は 1 秒もかかりません。
対象が決まると、台帳と装置の状態を調べて原因の候補を判定し、関係するマニュアルの章を検索します。LLM はこれらの材料を読み合わせ、足りなければ追加の確認を自ら選んで実行しながら、利用者に向けた回答を組み立てます。回答が出るまでには 20〜60 秒ほどかかるため、「これから何を確認するか」「ping の結果はどうだったか」といった途中経過を、コードが順に画面へ流して利用者を待たせないようにしています。
LLM が書いた文章も、そのまま利用者に返すわけではありません。マニュアルに存在しない章を引用していれば取り除き、当団体の確認が必要なのに連絡先が抜けていれば書き足します。日本語を含まない出力は定型文に差し替えます。いずれも試験中に実際に起きた誤りへの対策で、LLM の前後をコードで挟むことで、回答の品質を一定以上に保っています。
窓口で扱わない質問(参加や料金、接続先の選び方の相談など)や、調べても根拠が見つからない質問には、推測で答えずに定型文で Discord の窓口へご案内します。判定のパターンと文面は設定ファイルに置いてあり、コードを変えずに調整できます。
MARS との連携とプロンプトインジェクション対策
本システムは MARS から情報を読み取るだけで、MARS や装置へ書き込む経路は持っていません。読み取れる範囲も、利用者が MARS の画面で見られる範囲と同じです。
LLM を業務システムにつなぐうえで避けて通れないのが、プロンプトインジェクション(入力に紛れ込ませた指示で LLM の振る舞いを変える攻撃)への備えです。本システムでは、LLM が指示どおりに動かなくなる可能性があることを前提に設計しました。LLM が決められるのは「利用者の資源のうち、どれを調べるか」だけで、どの装置にどのコマンドを送るか、どの情報を返すかはすべてコードが決めます。LLM から渡された対象は、コードが利用者本人の資源であることを確かめてから処理し、装置から返ってきた結果も、その利用者に関係する部分だけに絞ってから LLM に渡します。
flowchart LR
  LLM["LLM<br/>調べる対象を選ぶ"] --> Check{"コードが対象を検証<br/>利用者本人の資源か"}
  Check -- いいえ --> Stop["処理しない"]
  Check -- はい --> Run["コードが決めた<br/>確認だけを実行"]
  Run --> Filter["利用者に関係する<br/>部分だけに絞る"]
  Filter --> LLM
このため、仮に LLM が攻撃者の指示に従ってしまったとしても、他の契約の情報を引き出したり、任意のコマンドを装置に送ったりすることはできません。安全性を LLM の賢さに頼らず、コードの側で担保しているのが本システムの特徴です。あわせて、問い合わせと関係のない発言には外部の文章を渡さない、利用者の発言を指示文と区別して渡す、出力をコードで検査するといった対策で、LLM がだまされにくく、だまされても影響が出にくい作りにしています。
申請についての相談では、申請の点検と「申請の前提関係表」が働きます。点検は、失敗・保留中の申請だけでなく、VNI(L2 ネットワークを識別する番号)を確保しただけで物理ポートを紐づけていない、IP トランジット(利用者のアドレスを当団体経由でインターネットへ広報するサービス)に広報経路フィルタ(広報してよい経路の一覧)が無い、仮想サーバーの仮想 NIC(ネットワークアダプター)が未接続といった「申請の不足」もコードで見つけます。前提関係表は MARS のソースコードをもとに 28 種類の申請の依存関係をまとめたもので、「仮想サーバー(VM)を ER と BGP でつなぎたい」といった要望から、必要な申請とその順番を組み立てます。すでにお持ちの構成は MARS の一覧で確認して省くので、その契約に合った手順をご案内できます。マニュアルの「よくある申請の例」に載っていない組み合わせにも対応できるのが利点です。
LG を活用した、人と共用できる RAG
RAG(Retrieval-Augmented Generation)は、文書を検索し、見つかった内容をもとに LLM に回答させる手法です。一般的な RAG では、文書を細かく分けてベクトル DB(文章の意味を数値の並び=ベクトルに変換して検索するデータベース)に入れ、AI 専用の知識ベースを用意します。本システムではそれを作らず、利用者や運用担当者が普段読んでいる文書と、普段使っている LG を、そのまま AI の参照先にしました。
flowchart LR
  subgraph Sources["文書(人が読み、人が直す)"]
    W["ユーザーマニュアル"]
    T["通信できないときの手引"]
    O["故障切り分け手順書"]
    P["MARS のソースコード"]
  end

  subgraph Live["装置の状態"]
    LGO["作業者向け LG<br/>ER+Nexus leaf"]
  end

  subgraph AI["問い合わせ Web"]
    S["マニュアル検索"]
    D["切り分け"]
    PL["申請の前提関係表"]
  end

  W --> S
  T --> S
  O -- "手順をコードに移す" --> D
  P -- "根拠付きで表にする" --> PL
  LGO --> D

  Human["運用担当者・修理作業者"] --> O
  Human --> LGO
  Customer["利用者"] --> W
  Customer --> T
AI が引用するのは、利用者向けのユーザーマニュアルと「通信できないときの手引」です。LLM は検索で見つかった複数の節を読み、質問に必要な部分を選んで、手順としてつながるように説明します。回答には「『章名』節番号」の形で出典を示し、引用した節の画面例も一緒に表示するので、利用者も担当者も同じ文書を開いて内容を確かめられます。文書を直せば取り込み直すだけで回答に反映され、ベクトルを作り直す手間もありません。検索は Markdown を節ごとに分けた単純なキーワード検索ですが、文書の種類ごとの重み付けや「VM」と「仮想サーバー」のような言い換えの補完を入れています。ベクトル検索や、検索結果を並べ替えるモデル(Reranker)も比較しましたが、この文書量では精度に差が出なかったため採用していません。
運用担当者向けの故障切り分け手順書は、検索の対象にはせず、手順そのものを切り分けの処理としてコードに書き移しました。その処理が装置の状態を確かめるのに使うのが、故障修理の作業者向けに用意した LG です。利用者向けの LG は ER だけを対象にしていますが、作業者向けの LG はデータセンター内で仮想サーバーや拠点の回線を収容するスイッチ(Cisco Nexus、以下 leaf)も対象に含み、VNI・EVPN(VPN の経路情報を BGP で交換する方式)・MAC アドレス・VRF の経路と BGP など、Nexus の OS である NX-OS での切り分けに必要な問い合わせを備えています。どちらも当団体で開発した同じ LG のソースコードから立てており、見られる装置は構成管理ツール ansible の装置一覧で必要最小限に絞っています。
flowchart TD
  Start["L3VPN の切り分け<br/>VRF-000030"] --> Ledger["MARS の台帳<br/>VRF・SVI・相互接続"]
  Ledger --> Leaf{"収容 leaf の状態を<br/>LG で取れるか"}
  Leaf -- "取れない" --> Unk["未確認として返す"]
  Leaf -- 取れる --> SVI["SVI・ポートのリンク"]
  SVI --> Ping["利用者ルーターへの ping"]
  Ping --> BGP{"ER との BGP"}
  BGP -- 確立 --> Adv{"広報するアドレスが<br/>ER へ出ているか"}
  Adv -- "出ていない" --> F1["当団体側の問題(確定)<br/>引き継ぎ票を出す"]
  Adv -- 出ている --> Def{"default 経路"}
  BGP -- 未確立 --> F2["原因の候補(可能性)"]
  Def -- ない --> F3["原因の候補"]
  Def -- ある --> OK["当団体側は正常<br/>利用者側の確認項目を案内"]
上の図は L3VPN の場合の切り分けの流れです。BGP 接続・L2VPN(拠点間を同じ L2 ネットワークでつなぐサービス)・L3VPN のそれぞれについて、台帳にある本来の構成と LG で見た実際の状態を突き合わせ、「確認できた事実」「原因の候補(確定か、可能性か)」「次に確認すること」「確認できなかったこと」に分けて結果を返します。装置を 1 台も確認できなかった場合に「異常なし」と言ってしまわず、「未確認」と正直に返すのもコードの役目です。LLM はこの結果を文章にするだけで、仮説を立てたり次に何を調べるかを選んだりはしません。
人と AI が同じ LG を見ていることは、引き継ぎの場面で効いてきます。AI が確認した LG の出力は、修理作業者が同じ LG で見るものと同じなので、担当者は AI の調査結果を出発点に、同じ問い合わせを打ち直して続きを調べられます。
管理画面
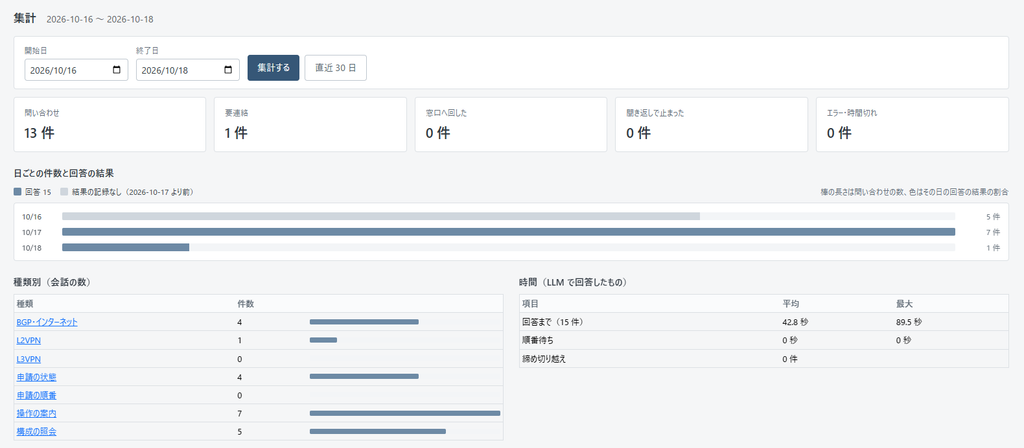
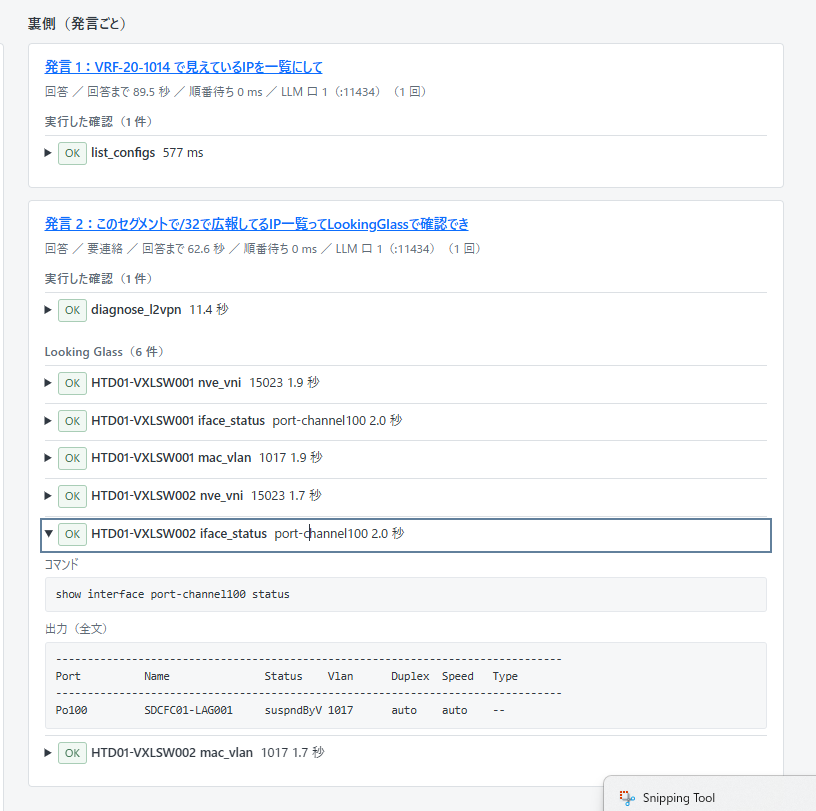
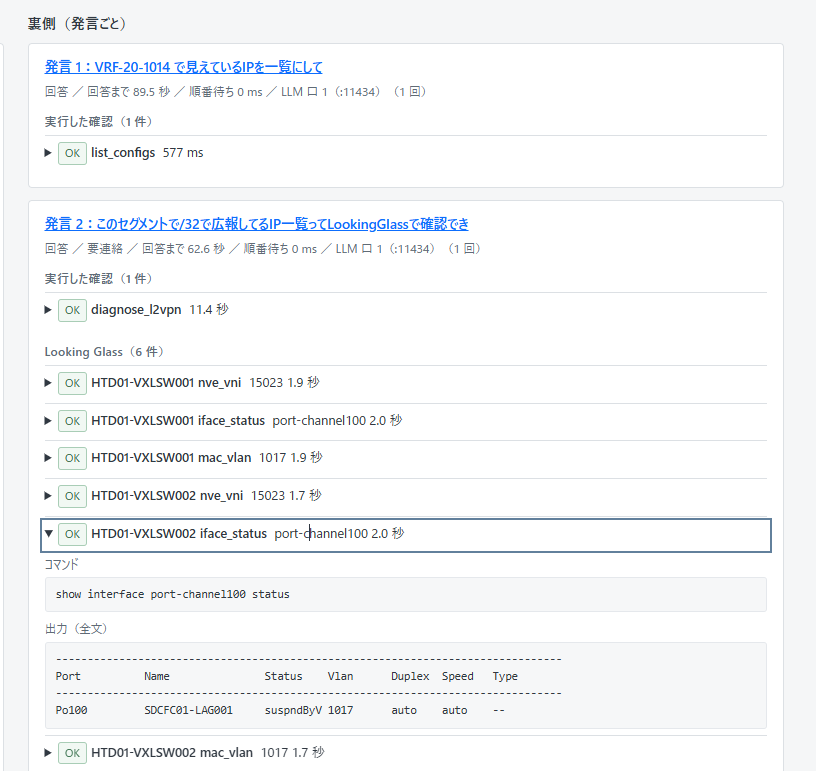
管理者アカウントでログインすると、管理画面が開きます。現在の処理状況、問い合わせの一覧、会話の詳細、集計を確認できる閲覧専用の画面です。会話の詳細では、利用者に見えていた会話に加えて、その裏で実行した確認の結果や LG の出力、処理時間なども見られます。
利用者が Discord で問い合わせ番号を伝えれば、担当者は管理画面でその会話を開き、AI がどこまで調べたかを把握したうえで対応を始められます。会話とツールの実行記録はすべて保存しており、監査にも使えます。
問い合わせの定期調査による品質向上
回答の品質は、作った時点の出来に任せず、実際に寄せられた問い合わせを定期的に調べて高めていきます。調査では管理画面の集計を使い、窓口へ回した質問、聞き返しの途中で止まった会話、誤った回答を洗い出して、マニュアルや手引、聞き取りの処理、評価用の例文に反映します。
flowchart LR
  Q["問い合わせの記録"] --> ADM["管理画面の集計"]
  ADM --> Esc["窓口へ回した質問"]
  ADM --> Stall["聞き返しで止まった会話"]
  ADM --> Bad["誤った回答"]

  Esc --> Doc["マニュアル・手引に追記"]
  Stall --> Hear["聞き取りを改善"]
  Bad --> Case["評価の例文に追加"]

  Doc --> KB["検索対象に反映"]
  Case --> Eval["全例文で採点"]
  Eval -- 劣化なし --> Rel["反映"]
  KB --> Q
  Rel --> Q
評価用の例文は現在 50 件あります。例文ごとに、回答に含まれるべき語、含まれてはいけない語、呼ばれるべきツールを定めておき、変更のたびにすべての例文を流して自動で採点します。含まれてはいけない語には他の契約のコードを入れており、回答に他契約の情報が混ざらないことも毎回確かめています。故障の場面は LG の出力を固定データに差し替えて再現するので、実機に手を加えずに、トンネル断や BGP の設定不一致、経路の広報漏れといった状況を繰り返し試せます。
例文の多くは、本番の契約で試験したときに実際に誤答した質問から作りました。2 問目以降でツールを呼ばずに推測で答えたこと、マニュアルに通しの手順が無い組み合わせに答えられなかったこと、ロールプレイを装った指示に従ってしまったことなどが、それぞれ例文になり、対策が入っています。直近の評価では 44 件中 196/197 点を得ています。
LLM の実行環境
LLM サーバーには T4 を 4 枚搭載し、GPU ごとに Ollama を 1 つずつ立てています。対話サーバーは処理中の件数が少ない GPU に問い合わせを振り分けるので、4 件までは待たずに同時に処理できます。それを超えて混み合った場合も断らずに受け付け、待ち順を表示して順番に処理します。待っている間に画面を閉じても、回答は会話の記録に残ります。
モデルは qwen3:8b・14b・32b を比べたうえで 14b を選びました。8b は速いもののロールプレイを装った指示を防げず、32b は精度が変わらないまま応答が 3 倍近く遅くなったためです。応答を速くするために、回答の前に推論の過程を書き出す機能(thinking)は止め、一度に扱える入力の長さ(文脈長)は 16K トークンに設定しています。長い会話や大きなログが貼られた場合は、LLM を呼ぶ前に入力の量を見積もり、古いやり取りから順に削って文脈長に収めています。
今後の展開
本システムは一般提供を開始しています。
今後の取り組みで最も重視しているのは、故障の切り分け手順の高度化です。設定や構成の不備といったソフトウェア側の故障については、原因の特定から修理までを本システムの中で完結させることを目指します。
ルーターやスイッチの故障、回線断といった物理的な故障についても、故障検知の仕組みと連動して、利用者に影響の範囲や修理完了の見込み時間をお知らせするなど、サポート窓口に求められる幅広い役割を担えるようにしていきます。
あわせて、実際に寄せられる問い合わせへの対応実績を積み重ね、7 章で紹介した定期調査を通じて回答の精度をさらに高めていきます。試験だけでは見えなかった質問の傾向や言い回しも、運用を続けるなかで文書や聞き取りの処理に取り込んでいく考えです。
また、現在の主な役割は故障対応ですが、今後は申し込みの方法やシステムの使い方、サービスの仕様についての質問など、より幅広い問い合わせに答えられるよう対応範囲を広げていきます。窓口に寄せられる問い合わせの多くを本システムで受け止め、担当者が当団体にしかできない対応に集中できる環境を目指します。
開発成果の提供について
本成果物はオンプレミス型サポートシステムとなります。任意の組織、団体等へ導入いただけます。
成果提供に関する問い合わせは下記までお願いいたします。
お問い合わせ先
会運営本部 研究開発センタ 営業担当(eigyo-dev-ml@m.sdconw.com)
\ 最新情報をチェック /